เคยไหม สั่ง agent แก้โค้ดมาตั้งแต่เช้า พอตกบ่ายมันกลับไปตั้งชื่อตัวแปรแบบที่คุณห้ามไว้ หรือลืมว่าเคยตกลงกันว่าจะไม่แตะไฟล์ config ไม่ใช่ว่า agent ขี้ลืม แต่มันชนเพดานของสิ่งที่เรียกว่า context window
Context window คืออะไร
Context window คือปริมาณข้อความสูงสุดที่โมเดล AI มองเห็นได้ในการตอบครั้งหนึ่ง นับเป็น token และรวมทุกอย่างตั้งแต่คำสั่งระบบ ประวัติการคุย ไฟล์ที่ agent เปิดอ่าน ไปจนถึงคำตอบที่โมเดลกำลังเขียนอยู่
เอกสารของ Anthropic เรียก context window ว่า working memory หรือความจำใช้งานของโมเดล ซึ่งเป็นคนละเรื่องกับความรู้ที่โมเดลได้จากการเทรน เทียบง่ายๆ ความรู้จากการเทรนคือสิ่งที่วิศวกรคนหนึ่งเรียนมาทั้งชีวิต ส่วน context window คือโต๊ะทำงานตรงหน้าที่วางเอกสารได้จำกัด อะไรไม่ได้วางบนโต๊ะ เขาก็มองไม่เห็นในตอนนั้น
ขนาดของ context วัดเป็น token ซึ่งเป็นหน่วยย่อยของข้อความ ภาษาอังกฤษหนึ่งคำมักเป็น 1 ถึงไม่กี่ token ส่วนภาษาไทยมักใช้ token มากกว่าเมื่อความยาวเท่ากัน (อ่านเพิ่มใน Token คืออะไร) ใน agent สำหรับเขียนโค้ด สิ่งที่อยู่ใน context มีประมาณนี้
- คำสั่งระบบ (system prompt) และรายการเครื่องมือที่ agent ใช้ได้
- ไฟล์กฎของโปรเจกต์ เช่น CLAUDE.md หรือ AGENTS.md
- ทุกข้อความที่คุณพิมพ์และที่ agent ตอบ
- เนื้อหาของไฟล์ที่ agent เปิดอ่าน
- ผลลัพธ์จากคำสั่งที่รัน เช่น log ของเทสต์หรือ build
- คำตอบที่โมเดลกำลังเขียนในรอบนั้น รวมถึงส่วนที่โมเดลคิดก่อนตอบ
ทำไม context ของ agent ถึงเต็มเร็วกว่าการแชต
เพราะ agent ไม่ได้มีแค่ข้อความสั้นๆ ไปมา ทุกครั้งที่มันเปิดไฟล์หรือรันคำสั่ง ผลลัพธ์ทั้งก้อนจะถูกเพิ่มเข้าไปใน context และทุกคำขอถัดไปจะส่งประวัติทั้งหมดนี้ให้โมเดลอ่านใหม่
agent ทำงานเป็นลูป อ่าน แก้ ตรวจ แล้ววนซ้ำ (อ่านว่า AI Agent ทำงานอย่างไร) ทุกรอบจึงมีของใหม่วางเพิ่มบนโต๊ะ ลองดูคร่าวๆ ว่าอะไรกินที่แค่ไหน ตัวเลขจริงขึ้นกับภาษาโปรแกรม ความยาวบรรทัด และ tokenizer ของแต่ละโมเดล
| สิ่งที่เข้า context | ขนาดโดยประมาณ |
|---|---|
| คำสั่งสั้นๆ ที่คุณพิมพ์ | หลักสิบถึงหลักร้อย token |
| ไฟล์โค้ดหนึ่งไฟล์ ราว 300 บรรทัด | หลายพัน token |
| log ของเทสต์หรือ build ที่ยาวๆ | ได้ถึงหลักหมื่น token |
| ไฟล์ lock หรือไฟล์ข้อมูลขนาดใหญ่ | อาจกินที่เกือบทั้งหมด |
งานแก้บั๊กหนึ่งงานที่ agent เปิดอ่านสิบไฟล์และรันเทสต์ห้ารอบ จึงกิน context ได้มากกว่าการแชตทั้งวัน เอกสารของ Claude Code ยังอธิบายว่าเซสชันที่เปิดค้างไว้นานจะใช้โควตาเพิ่มขึ้นเรื่อยๆ เพราะทุกคำถาม แม้สั้นแค่บรรทัดเดียว ก็ต้องส่งประวัติทั้งเซสชันไปด้วย
อธิบายด้วยภาพ
context ค่อยๆ เต็มระหว่างทำงาน
- เริ่มงานคำสั่งระบบและไฟล์กฎ
- ระหว่างทำไฟล์ ผลเทสต์ และแชตสะสม
- ใกล้เต็มสรุปย่อ (compact)
หลัง compact คำขอและโค้ดสำคัญยังอยู่ แต่คำสั่งละเอียดช่วงต้นอาจหายไป ส่วน CLAUDE.md ที่รากโปรเจกต์ถูกอ่านใหม่ทุกครั้ง
Context เต็มแล้วเกิดอะไรขึ้น
เมื่อ context ใกล้เต็ม agent จะสรุปประวัติการทำงานให้สั้นลง เรียกว่า compact แล้วทำงานต่อจากบทสรุปนั้น ข้อเสียคือรายละเอียดบางอย่าง โดยเฉพาะคำสั่งที่คุณพิมพ์ไว้ตั้งแต่ช่วงต้น อาจหายไปในบทสรุป นี่คืออาการลืมที่หลายคนเจอ
เอกสารของ Claude Code บอกว่าบทสรุปจะเก็บคำขอของคุณและโค้ดสำคัญไว้ แต่คำสั่งละเอียดช่วงต้นอาจหลุด ส่วนไฟล์ CLAUDE.md ที่รากโปรเจกต์จะรอดจากการ compact และถูกอ่านใหม่จากดิสก์ทุกครั้ง กฎที่ต้องใช้ตลอดจึงควรอยู่ในไฟล์ ไม่ใช่ในแชต
ยังไม่เต็มก็อาจเริ่มพลาด
context ที่ใหญ่ขึ้นไม่ได้แปลว่าดีขึ้นเสมอ เอกสารของ Anthropic เรียกอาการนี้ว่า context rot คือยิ่งจำนวน token มากขึ้น ความแม่นและความสามารถในการดึงรายละเอียดกลับมาใช้ก็ลดลง การคัดว่าอะไรควรอยู่ใน context จึงสำคัญพอๆ กับขนาดของมัน
คำสั่งที่ใช้จัดการ context
| อยากทำอะไร | Claude Code | Codex CLI |
|---|---|---|
| ดูว่า context ใช้ไปเท่าไร | /context | /status |
| สรุปย่อเพื่อคืนพื้นที่ | /compact ต่อท้ายด้วยเรื่องที่อยากให้เก็บได้ | /compact |
| เริ่มใหม่เมื่อเปลี่ยนงาน | /clear | /new หรือ /clear |
ตัวอย่างการบอกให้เก็บเรื่องที่สำคัญตอน compact ใน Claude Code
/compact focus on the API changes and the tests that still failContext window ใหญ่แค่ไหนถึงพอ
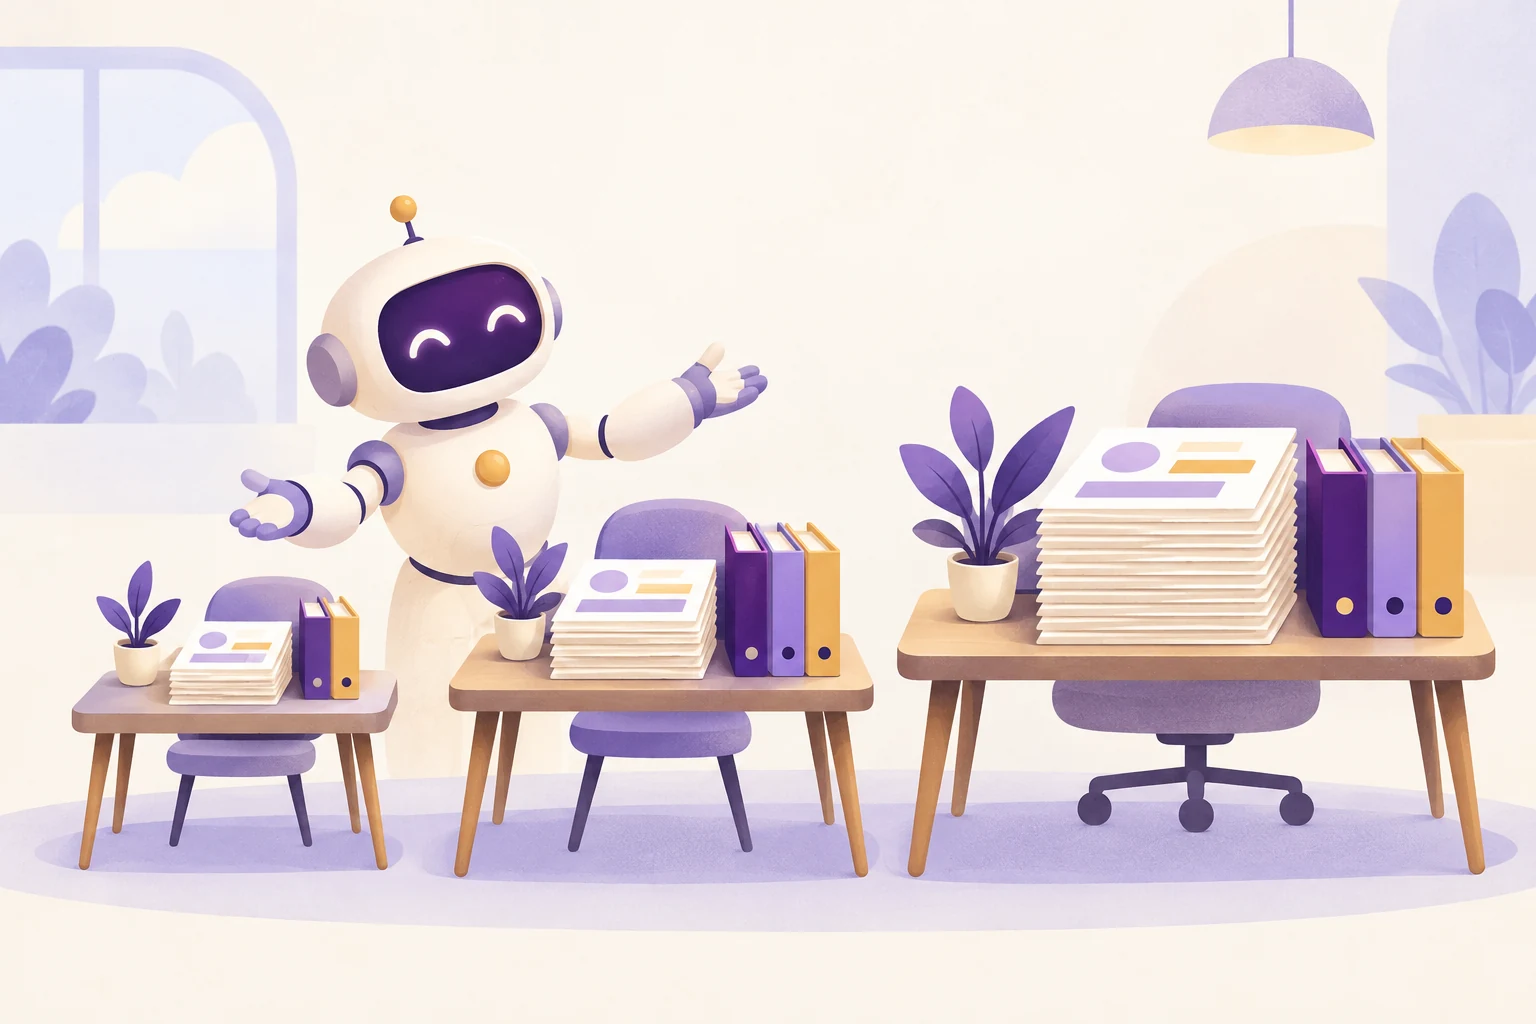
สำหรับงานเขียนโค้ด 64K token พอสำหรับงานเล็กที่แตะไม่กี่ไฟล์ 128K เหมาะกับฟีเจอร์ที่ต้องอ่านโค้ดหลายไฟล์ในโปรเจกต์ขนาดกลาง และ 256K เหมาะกับโปรเจกต์ใหญ่หรืองานยาวที่ต้องเปิดไฟล์จำนวนมาก ตัว K ในที่นี้หมายถึงหลักพัน token
| ขนาด context | เหมาะกับงาน | ตัวอย่าง |
|---|---|---|
| 64K | งานเล็กที่จบในไม่กี่ไฟล์ | แก้บั๊กจุดเดียว เขียนสคริปต์ เพิ่มเทสต์ให้ฟังก์ชันหนึ่ง |
| 128K | งานที่ต้องอ่านโค้ดหลายไฟล์ | เพิ่มฟีเจอร์ที่แตะ API ฐานข้อมูล และหน้าเว็บพร้อมกัน |
| 256K | โปรเจกต์ใหญ่และงานยาว | รีแฟกเตอร์ทั้งโมดูล ไล่บั๊กที่ข้ามหลายส่วนของระบบ |
แต่ขนาดไม่ใช่ทุกอย่าง agent ที่ทำงานใน context 256K ซึ่งเต็มไปด้วย log เก่า อาจทำงานได้แย่กว่า agent ที่เพิ่งเริ่มเซสชันใหม่ใน context 128K ที่มีแต่ข้อมูลที่เกี่ยวข้อง ขนาดที่ใหญ่ช่วยให้มีที่วาง ส่วนการจัด context ช่วยให้ agent ใช้ที่นั้นได้ดี
โมเดลแต่ละตัวก็มีเพดานของตัวเอง เช่น การ์ดโมเดลบน Hugging Face ระบุว่า Qwen3.8-27B ซึ่งเป็นโมเดล open source รองรับ context ได้ 262,144 token หรือประมาณ 256K ส่วนผู้ให้บริการแต่ละรายอาจกำหนดขนาด context ตามแพ็กที่ขาย
วิธีใช้ context ให้คุ้ม ไม่ให้ agent ลืมเรื่องสำคัญ
หลักคือให้ context มีแต่สิ่งที่งานตอนนี้ต้องใช้ และเก็บสิ่งที่ต้องจำระยะยาวไว้ในไฟล์ ไม่ใช่ในประวัติแชต
- หนึ่งเซสชัน หนึ่งงาน พอเปลี่ยนไปทำเรื่องที่ไม่เกี่ยวกัน ให้
/clearหรือเปิดแชตใหม่ context เก่าที่ค้างอยู่ทำให้ทุกคำขอหนักขึ้นโดยไม่ได้อะไรกลับมา - เขียนกฎถาวรไว้ในไฟล์ ข้อห้าม คำสั่ง build และ test และสไตล์โค้ด ใส่ไว้ใน CLAUDE.md หรือ AGENTS.md เพราะ agent อ่านไฟล์เหล่านี้ทุกครั้งที่เริ่มงาน (ดูวิธีเริ่มใน คู่มือ Claude Code และ คู่มือ Codex CLI)
- compact เองก่อนจะเต็ม ทำตอนจบงานย่อยแต่ละช่วง และบอกว่าให้เก็บอะไร ดีกว่าปล่อยให้ระบบสรุปเองกลางงานที่ยังค้างอยู่
- ให้ agent จดความคืบหน้าลงไฟล์ งานยาวข้ามวัน ให้ agent เขียนแผนและสิ่งที่ทำไปแล้วลงไฟล์ เช่น PLAN.md พอเริ่มเซสชันใหม่ก็สั่งให้อ่านไฟล์นี้ก่อน
- อย่าโยนของใหญ่เข้ามาทั้งก้อน แทนที่จะให้ agent อ่าน log หมื่นบรรทัด ให้กรองเฉพาะส่วนที่ผิดพลาดก่อน เช่น
npm test 2>&1 | grep -A 5 FAIL - สั่งให้เจาะจง บอกชื่อไฟล์หรือฟังก์ชันที่เกี่ยวข้อง agent จะได้ไม่ต้องเปิดไล่ทั้งโปรเจกต์
- ใช้ sub-agent กับงานค้นหาใหญ่ๆ sub-agent มี context window ของตัวเอง ทำงานเสร็จแล้วส่งแค่บทสรุปกลับมา context ของงานหลักจึงไม่บวม
Context window ของ buzzAI
buzzAI ใช้โมเดล open-weight Qwen3.8-27B ขนาด context ขึ้นกับแพ็ก Mini ได้ 64K Day Pass, Week Pass และ Lite ได้ 128K ส่วน Solo ได้ 256K ทุกแพ็กไม่คิดค่า token เซสชันยาวๆ จึงไม่ทำให้ค่าใช้จ่ายเพิ่มตามจำนวน token แต่เพดาน context ของแพ็กยังเป็นตัวกำหนดว่า agent เห็นงานได้ทีละเท่าไร วิธีจัด context ข้างบนจึงยังใช้ได้เหมือนเดิม แพ็ก Personal รัน agent ได้ทีละ 1 ตัว ส่วนแพ็กบริษัทรันได้ 1–8 ตัวพร้อมกัน และช่วงที่คนใช้เยอะอาจต้องรอคิว ตอนนี้ API ยังไม่เปิดใช้ เรากำลังเปิดให้ขอร่วมทดสอบรอบที่ 1 และจะส่ง API key ให้ทางอีเมลเมื่อมีผู้สมัครครบโควต้าที่กำหนด ดูแพ็กทั้งหมดได้ที่หน้าราคา
คำถามที่พบบ่อย
Context window กับ memory ของ AI ต่างกันอย่างไร?
Context window คือสิ่งที่โมเดลเห็นในงานตอนนั้น และหายไปเมื่อเริ่มเซสชันใหม่ ส่วน memory คือข้อมูลที่เครื่องมือบันทึกไว้ในไฟล์ แล้วโหลดกลับเข้า context ตอนเริ่มเซสชันถัดไป เช่น CLAUDE.md และ auto memory ของ Claude Code หรือ AGENTS.md ของ Codex
ทำไม Claude Code ขึ้นว่ากำลัง compact?
เพราะ context ของเซสชันใกล้เต็ม Claude Code จึงสรุปประวัติการทำงานให้สั้นลงอัตโนมัติเพื่อทำงานต่อได้ ถ้าไม่อยากให้รายละเอียดสำคัญหาย ให้สั่ง /compact เองพร้อมบอกว่าต้องเก็บเรื่องไหน หรือใช้ /clear เมื่อเปลี่ยนไปทำงานอื่น
Context window ใหญ่ขึ้นทำให้ AI ฉลาดขึ้นไหม?
ไม่เสมอไป context ที่ใหญ่ขึ้นทำให้ใส่ข้อมูลได้มากขึ้น แต่เมื่อจำนวน token มากขึ้น ความแม่นในการดึงรายละเอียดกลับมาใช้มักลดลง ซึ่งเรียกว่า context rot การคัดเฉพาะข้อมูลที่เกี่ยวข้องจึงสำคัญพอๆ กับขนาด
1 token เท่ากับกี่ตัวอักษร?
ไม่ตายตัว ขึ้นกับภาษาและ tokenizer ของแต่ละโมเดล ภาษาอังกฤษหนึ่งคำมักเป็น 1 ถึงไม่กี่ token ส่วนภาษาไทยมักใช้ token มากกว่าเมื่อความยาวเท่ากัน วิธีที่แม่นที่สุดคือดูตัวเลขที่เครื่องมือรายงาน เช่น /context ใน Claude Code หรือ /status ใน Codex CLI
เขียนโค้ดด้วย agent ควรใช้ context เท่าไร?
งานเล็กที่แตะไม่กี่ไฟล์ใช้ 64K ก็พอ งานที่ต้องอ่านหลายไฟล์ในโปรเจกต์ขนาดกลางควรมี 128K ส่วนโปรเจกต์ใหญ่หรืองานยาวต่อเนื่องเหมาะกับ 256K ขึ้นไป
แหล่งอ้างอิง
ข้อมูล ณ วันที่อัปเดต แพ็ก โควตา และคำสั่งของแต่ละเครื่องมือเปลี่ยนได้บ่อย ก่อนใช้งานจริงควรตรวจกับเอกสารทางการที่ลิงก์ไว้ในแหล่งอ้างอิง


