เคยไหมครับ สั่ง agent แก้บั๊กแค่ตัวเดียว แต่พอเปิดดูการใช้งานกลับเห็นตัวเลขหลายแสน token หรือแชตกับ AI มาทั้งวันยังใช้ไม่ถึงครึ่งของที่ agent ใช้ในชั่วโมงเดียว บทความนี้อธิบายว่า token คืออะไร ทำไมทุกเจ้าคิดเงินด้วยหน่วยนี้ และทำไม coding agent ถึงกิน token เร็วกว่าที่คิด
Token คืออะไร
token คือชิ้นส่วนเล็กๆ ที่โมเดล AI ใช้ตัดข้อความก่อนอ่าน อาจเป็นทั้งคำ ส่วนของคำ เครื่องหมาย หรือช่องว่าง โมเดลไม่ได้เห็นตัวอักษรแบบที่เราเห็น แต่เห็นเป็นลำดับตัวเลข ซึ่งแต่ละตัวแทน token หนึ่งชิ้น
ลองนึกภาพเลโก้ ประโยคหนึ่งประโยคคือของเล่นที่ต่อเสร็จแล้ว ก่อนโมเดลจะอ่าน ระบบจะแยกมันกลับเป็นชิ้นตัวต่อ คำที่เจอบ่อยอาจเป็นชิ้นเดียวทั้งคำ ส่วนคำยาวหรือคำแปลกจะถูกแยกเป็นหลายชิ้น เครื่องมือที่ทำหน้าที่ตัดนี้เรียกว่า tokenizer
สิ่งที่หลายคนไม่ทันนึกคือ โค้ดก็ถูกตัดเป็น token เหมือนกัน ชื่อตัวแปร วงเล็บ เครื่องหมายจุด การเว้นวรรคย่อหน้า และ error log ยาวๆ ล้วนนับเป็น token ทั้งหมด
ข้อมูลจาก tokenizer ของ OpenAI บอกว่าในทางปฏิบัติ token หนึ่งชิ้นเฉลี่ยราว 4 bytes สำหรับข้อความภาษาอังกฤษจึงประมาณตัวอักษร 4 ตัว แต่ตัวเลขนี้เป็นค่าเฉลี่ยคร่าวๆ เท่านั้น โมเดลแต่ละตระกูลใช้ tokenizer ต่างกัน ข้อความเดียวกันจึงนับได้ไม่เท่ากัน ถ้าต้องการตัวเลขจริง ผู้ให้บริการส่วนใหญ่มีเครื่องมือนับ token ให้ใช้ก่อนส่งคำขอ
ภาษาไทยใช้ token มากกว่าภาษาอังกฤษไหม
โดยทั่วไปใช่ ตัวอักษรภาษาอังกฤษใช้พื้นที่ 1 byte ต่อตัว แต่ตัวอักษรไทยใช้ 3 bytes ต่อตัวในรูปแบบ UTF-8 และ tokenizer ส่วนใหญ่ถูกสร้างจากข้อความภาษาอังกฤษเป็นหลัก ข้อความไทยที่สื่อความเท่ากันจึงมักถูกตัดเป็น token มากกว่า
แต่ไม่ต้องกังวลถึงขั้นต้องสั่ง agent เป็นภาษาอังกฤษ เพราะในงานเขียนโค้ด คำสั่งที่เราพิมพ์เป็นแค่ส่วนเล็กมากของ token ทั้งหมด ส่วนที่กินจริงคือไฟล์โค้ดและผลลัพธ์ของคำสั่งที่ agent อ่าน
ทำไม AI ถึงคิดเงินตาม token
เพราะต้นทุนของผู้ให้บริการขึ้นกับปริมาณข้อความที่การ์ด GPU ต้องประมวลผล ทั้งตอนอ่านสิ่งที่ส่งเข้าไปและตอนเขียนคำตอบออกมา token จึงเป็นหน่วยที่สะท้อนต้นทุนได้ตรงที่สุด เหมือนค่าไฟที่คิดตามหน่วยที่ใช้จริง
ถ้าเปิดหน้าราคาของผู้ให้บริการ API รายใหญ่ จะเห็นราคาแยกเป็นหลายช่อง โดยคิดต่อ 1 ล้าน token
| ประเภท | คืออะไร | ราคาโดยเปรียบเทียบ |
|---|---|---|
| Input token | ทุกอย่างที่ส่งให้โมเดลอ่าน: คำสั่งระบบ ประวัติแชต ไฟล์ ผลลัพธ์จากเครื่องมือ | ราคาฐาน |
| Output token | ข้อความ โค้ด และคำสั่งเรียกเครื่องมือที่โมเดลเขียนออกมา | แพงกว่า input หลายเท่า |
| Cached input | input ส่วนที่เคยส่งแล้วและอ่านซ้ำจาก cache | ถูกกว่า input ปกติมาก |
| Thinking token | ขั้นตอนคิดก่อนตอบของโมเดลที่รองรับ | คิดราคาเหมือน output |
ราคาจริงเปลี่ยนบ่อยและต่างกันมากระหว่างโมเดล จึงควรดูจากหน้าราคาทางการของผู้ให้บริการแต่ละรายเสมอ (ลิงก์อยู่ในแหล่งอ้างอิงท้ายบทความ)
ข้อสังเกตคือ output แพงกว่า input เพราะการเขียนต้องสร้างทีละ token ขณะที่การอ่านประมวลผลพร้อมกันได้ทีละมาก ส่วน thinking token มักถูกมองข้าม ทั้งที่งานยากบางงานโมเดลอาจคิดเป็นหมื่น token ก่อนตอบ
อธิบายด้วยภาพ
แก้ test 4 รอบ ส่ง input รวม 106K token
- รอบ 1 อ่านไฟล์14K
- รอบ 2 รัน test22K
- รอบ 3 แก้โค้ด31K
- รอบ 4 รัน test ซ้ำ39K
- รวม input ทั้งงาน106K
ตัวเลขสมมติเพื่อให้เห็นภาพ ทุกรอบส่งประวัติทั้งหมดไปใหม่ ยอดรวมจึงโตเร็วกว่าขนาดงาน
Coding agent ใช้ token มากแค่ไหน ทำไมถึงพุ่งเร็ว
มากกว่าการแชตหลายเท่า เพราะ agent ทำงานเป็นรอบ ทุกครั้งที่มันอ่านไฟล์ รันคำสั่ง หรือแก้โค้ด ระบบจะส่งบทสนทนาทั้งหมดพร้อมผลลัพธ์ล่าสุดกลับไปให้โมเดลอ่านใหม่ input ของแต่ละรอบจึงโตขึ้นเรื่อยๆ และยอดรวมทั้งงานโตเร็วกว่าขนาดของงานจริง
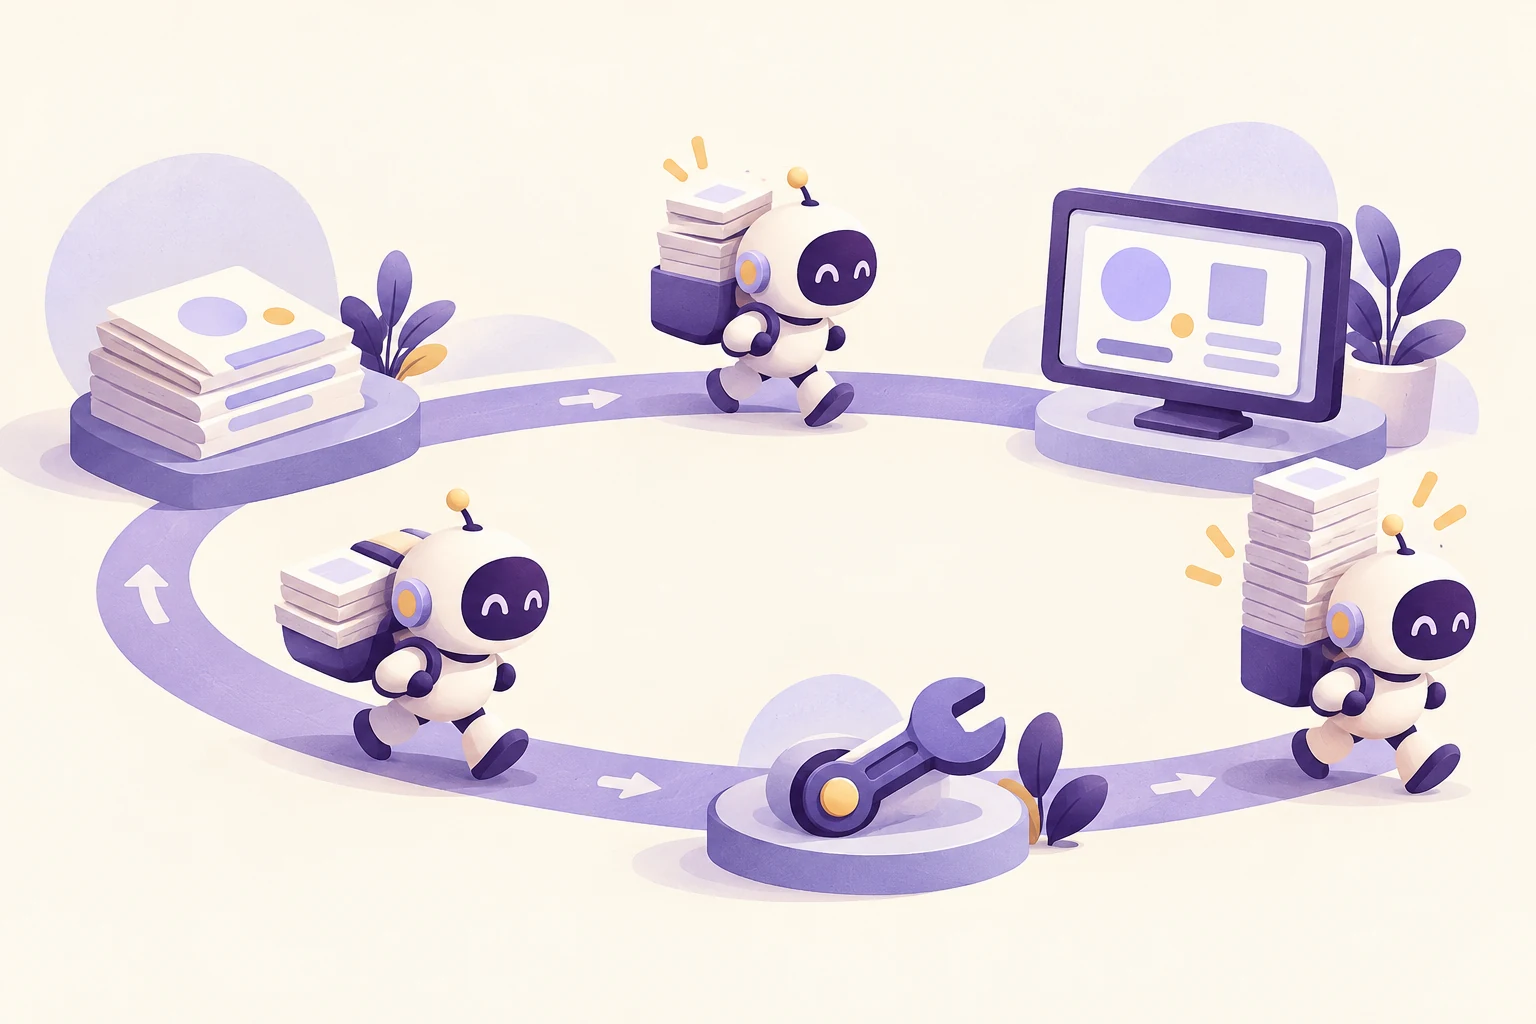
เอกสารของ Claude Code อธิบายตรงๆ ว่า ทุกคำขอจะส่งบทสนทนาทั้งหมดไปด้วย และทุกครั้งที่เรียกเครื่องมือก็จะเกิดคำขอใหม่ที่พ่วงผลลัพธ์ชุดนั้นไปอีก ลองดูตัวอย่างงาน "แก้ test ที่ fail" แบบง่ายๆ
| รอบ | agent ทำอะไร | input ที่ส่งในรอบนั้น (ตัวเลขสมมติ) |
|---|---|---|
| 1 | อ่านไฟล์ที่เกี่ยวข้อง | 14K |
| 2 | รัน test ดู error | 22K |
| 3 | แก้โค้ด | 31K |
| 4 | รัน test ซ้ำให้ผ่าน | 39K |
| รวม | 106K |
ตัวเลขในตารางเป็นตัวอย่างเพื่อให้เห็นภาพเท่านั้น สังเกตว่าแต่ละรอบต้องแบกของเดิมทั้งหมดไปด้วย ได้แก่ คำสั่งระบบ รายการเครื่องมือ ไฟล์ตั้งค่าโปรเจกต์ ไฟล์ที่อ่านไปแล้ว และ log ที่รันไปแล้ว งานจริงที่วนเป็นสิบๆ รอบจึงแตะหลักแสนหรือหลักล้าน token ได้ไม่ยาก
ตัวเร่งอื่นที่ทำให้ token พุ่ง
- เซสชันยาวที่ไม่เคยล้าง ถามคำถามสั้นๆ หนึ่งบรรทัดในเซสชันที่เปิดมาทั้งวัน ก็ยังต้องส่งประวัติทั้งวันไปด้วย
- หยุดพักนานแล้วกลับมาทำต่อ ถ้าพักนานเกินอายุของ cache ข้อความแรกหลังกลับมาจะต้องประมวลผล context ทั้งหมดใหม่ในราคาเต็ม
- sub-agent และ agent หลายตัว แต่ละตัวมี context และคำขอของตัวเอง ยิ่งแตกงานหลายตัวก็ยิ่งใช้ token คูณขึ้นตามจำนวน
- การสรุปบทสนทนา (compact) ตัวมันเองก็เป็นคำขอขนาดใหญ่ เพราะต้องอ่านสิ่งที่จะสรุปทั้งหมดก่อน
ข่าวดีคือผู้ให้บริการส่วนใหญ่มี prompt caching ส่วนที่ซ้ำจากรอบก่อนจะถูกอ่านจาก cache ในราคาที่ถูกกว่าปกติมาก จำนวน token ไม่ได้ลดลง แต่บิลไม่โตเร็วเท่าตัวเลข token
ลดการใช้ token ของ coding agent ได้อย่างไร
หลักใหญ่มีข้อเดียว คือทำให้ context เล็กเข้าไว้ เริ่มเซสชันใหม่เมื่อเปลี่ยนเรื่อง สั่งงานให้เจาะจง และอย่าให้ agent อ่านของที่ไม่จำเป็น
วิธีที่ใช้ได้จริงในชีวิตประจำวัน
- ล้างเซสชันเมื่อเปลี่ยนงาน ใน Claude Code ใช้
/clearเมื่อจะเริ่มงานที่ไม่เกี่ยวกับงานเดิม ประวัติเก่าที่ค้างอยู่จะกิน token ทุกข้อความถัดไป - สั่งงานให้ชัด "ปรับปรุงโค้ดให้ดีขึ้น" ทำให้ agent ไล่อ่านทั้งโปรเจกต์ ส่วน "เพิ่มการตรวจ input ในฟังก์ชัน login ที่ auth.ts" ทำให้อ่านแค่ไฟล์ที่จำเป็น
- กรอง output ก่อนส่งให้ agent แทนที่จะให้อ่าน log หมื่นบรรทัด ให้ grep เฉพาะบรรทัด error ก่อน
- ไฟล์ตั้งค่าโปรเจกต์ต้องสั้น ไฟล์อย่าง CLAUDE.md หรือ AGENTS.md ถูกโหลดทุกเซสชัน ถ้ายาวหลายร้อยบรรทัดก็เสีย token ทุกครั้ง
- ดูตัวเลขจริงเป็นระยะ ใน Claude Code พิมพ์
/usageเพื่อดูการใช้ token ของเซสชัน และดูว่าอะไรกินโควตามากที่สุด
ถ้าอยากเข้าใจว่าทำไม context ยิ่งยาวยิ่งมีปัญหา นอกจากเรื่องเงินแล้วยังมีเรื่องความจำของ agent ด้วย อ่านต่อได้ที่ Context window คืออะไร
ถ้าไม่อยากนั่งนับ token มีทางเลือกอะไรบ้าง
นอกจากจ่ายตาม token ผ่าน API แล้ว ยังมีอีกสองทาง คือแพ็กสมาชิกรายเดือนของเครื่องมือที่มีโควตาเป็นรอบเวลา และบริการแบบเหมาจ่ายที่ไม่คิดค่า token แต่จำกัดที่อย่างอื่นแทน แต่ละแบบเหมาะกับรูปแบบงานต่างกัน
| แบบ | ข้อดี | ข้อที่ต้องรู้ |
|---|---|---|
| จ่ายตาม token ผ่าน API | ใช้เท่าไรจ่ายเท่านั้น ยืดหยุ่น เลือกโมเดลได้ | งาน agent ยาวๆ ทำให้บิลคาดเดายาก |
| แพ็กสมาชิกของเครื่องมือ | ราคาต่อเดือนคงที่ ใช้คู่กับเครื่องมือของผู้ให้บริการนั้นได้ทันที | มีโควตารอบ 5 ชั่วโมงและรายสัปดาห์ ใช้หนักแล้วต้องรอรอบใหม่ |
| เหมาจ่ายแบบไม่คิดค่า token | ปล่อย agent ทำงานยาวได้โดยไม่ต้องเฝ้าตัวเลข | จำกัดที่จำนวน agent ที่รันพร้อมกัน ขนาด context และคิวช่วงคนใช้เยอะ |
หลายคนใช้หลายแบบผสมกัน เช่น ใช้แพ็กสมาชิกกับงานหลักที่นั่งทำเอง แล้วส่งงานยาว งานซ้ำ หรืองานเบื้องหลังไปที่บริการเหมาจ่าย ถ้าตอนนี้คุณเจอปัญหาโควตาของ Claude Code อ่านเรื่องนี้ละเอียดได้ที่ Claude Code ติด limit ทำอย่างไร
buzzAI ไม่คิดค่า token แล้วจำกัดอะไรแทน
buzzAI เป็น API สำหรับ coding agent แบบเหมาจ่ายที่ไม่คิดค่า token ใช้กับ Claude Code, Codex CLI และเครื่องมือที่ตั้ง base URL เองได้แบบ OpenAI-compatible ชื่อโมเดลใน API คือ Qwen3.8-27B โมเดล open-weight สัญญาอนุญาต Apache 2.0
สิ่งที่มีขอบเขตแทน token มี 3 อย่าง คือจำนวน agent ที่รันพร้อมกัน (แพ็ก Personal ได้ 1 agent แพ็กบริษัทได้ 1–8 ตัว), ขนาด context ตามแพ็ก (64K, 128K หรือ 256K) และคิวในช่วงที่คนใช้เยอะ ตอนนี้ API ยังไม่เปิดให้ใช้ทั่วไป เรากำลังเปิดให้ขอร่วมทดสอบรอบที่ 1 และจะส่ง API key ให้ทางอีเมลเมื่อมีผู้สมัครครบโควต้าที่กำหนด ดูรายละเอียดแพ็กได้ที่หน้าราคา
คำถามที่พบบ่อย
1 token เท่ากับกี่คำ?
ไม่ตายตัว ขึ้นกับภาษาและ tokenizer ของแต่ละโมเดล สำหรับข้อความภาษาอังกฤษ token หนึ่งเฉลี่ยราว 4 bytes หรือประมาณตัวอักษรอังกฤษ 4 ตัว ถ้าต้องการตัวเลขที่แน่นอน ให้ใช้เครื่องมือนับ token ของผู้ให้บริการรายนั้น
input token กับ output token ต่างกันอย่างไร?
input token คือทุกอย่างที่ส่งเข้าไปให้โมเดลอ่าน รวมคำสั่งระบบ ประวัติแชต ไฟล์ และผลลัพธ์จากเครื่องมือ ส่วน output token คือข้อความและคำสั่งที่โมเดลเขียนออกมา ผู้ให้บริการส่วนใหญ่ตั้งราคา output ต่อ token สูงกว่า input
ทำไมใช้ Claude Code ไม่นานแต่ token หมดเร็ว?
เพราะทุกครั้งที่ agent เรียกเครื่องมือ ระบบจะส่งบทสนทนาทั้งหมดพร้อมผลลัพธ์ใหม่กลับไปให้โมเดลอ่านอีกรอบ งานที่วนหลายรอบในเซสชันยาวจึงใช้ token สะสมเร็วมาก แม้ prompt caching จะช่วยลดราคาของส่วนที่อ่านซ้ำแล้วก็ตาม
พิมพ์คำสั่งเป็นภาษาไทยเปลือง token กว่าภาษาอังกฤษไหม?
โดยทั่วไปข้อความภาษาไทยใช้ token มากกว่าภาษาอังกฤษที่ยาวเท่ากัน แต่ในงาน coding agent คำสั่งที่เราพิมพ์เป็นส่วนเล็กมาก token ส่วนใหญ่มาจากโค้ด ไฟล์ และผลลัพธ์ของคำสั่งที่ agent อ่าน จึงสั่งงานเป็นภาษาไทยได้ตามสบาย
prompt caching ช่วยลดการใช้ token ได้ไหม?
prompt caching ไม่ได้ลดจำนวน token แต่ลดราคาของส่วนที่ถูกอ่านซ้ำ เพราะผู้ให้บริการคิดราคาการอ่านจาก cache ต่ำกว่า input ปกติมาก ส่วนการเขียน cache ครั้งแรกอาจแพงกว่าปกติ และ cache มีอายุจำกัด
แหล่งอ้างอิง
- Manage costs effectively — Claude Code Docscode.claude.com
- Token counting — Claude API Docsplatform.claude.com
- Prompt caching — Claude API Docsplatform.claude.com
- Pricing — Claude API Docsplatform.claude.com
- Pricing — OpenAI APIdevelopers.openai.com
- openai/tiktoken: a fast BPE tokeniser for use with OpenAI's models — GitHubgithub.com
ข้อมูล ณ วันที่อัปเดต แพ็ก โควตา และคำสั่งของแต่ละเครื่องมือเปลี่ยนได้บ่อย ก่อนใช้งานจริงควรตรวจกับเอกสารทางการที่ลิงก์ไว้ในแหล่งอ้างอิง


